python安装以及python采集(2022年4月更新)

如何用Python爬数据?(一)网页抓取

PHPer 2022-05-27 1789 0 1

这篇文章赞有900多,后面的回复也挺多,先整来,O(∩_∩)O哈哈~


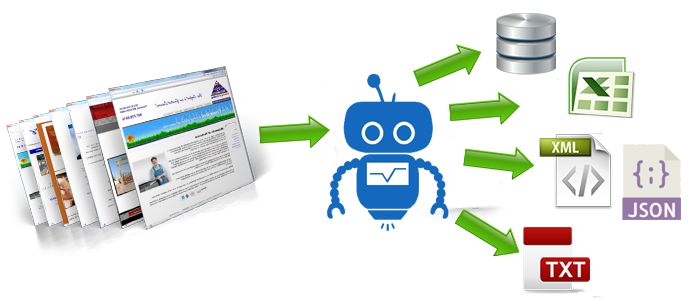
你期待已久的Python网络数据爬虫教程来了。本文为你演示如何从网页里找到感兴趣的链接和说明文字,抓取并存储到Excel。
4fc16fd562_normal.jpg

需求

我在公众号后台,经常可以收到读者的留言。

很多留言,是读者的疑问。只要有时间,我都会抽空尝试解答。

但是有的留言,乍看起来就不明所以了。

例如下面这个:

fdfe442152_normal.jpg

一分钟后,他可能觉得不妥(大概因为想起来,我用简体字写文章),于是又用简体发了一遍。

d7d7ae21fb_normal.jpg

我恍然大悟。

这位读者以为我的公众号设置了关键词推送对应文章功能。所以看了我的其他数据科学教程后,想看“爬虫”专题。

不好意思,当时我还没有写爬虫文章。

而且,我的公众号暂时也没有设置这种关键词推送。

主要是因为我懒。

这样的消息接收得多了,我也能体察到读者的需求。不止一个读者表达出对爬虫教程的兴趣。

之前提过,目前主流而合法的网络数据收集方法,主要分为3类:


  • 开放数据集下载;
  • API读取;
  • 爬虫。

前两种方法,我都已经做过一些介绍,这次说说爬虫。

a90bc58399_normal.jpg

概念

许多读者对爬虫的定义,有些混淆。咱们有必要辨析一下。

维基百科是这么说的:

网络爬虫(英语:web crawler),也叫网络蜘蛛(spider),是一种用来自动浏览万维网网络机器人。其目的一般为编纂网络索引

这问题就来了,你又不打算做搜索引擎,为什么对网络爬虫那么热心呢?

其实,许多人口中所说的爬虫(web crawler),跟另外一种功能“网页抓取”(web scraping)搞混了。

维基百科上,对于后者这样解释:

Web scraping, web harvesting, or web data extraction is data scraping used for extracting data from websites. Web scraping software may access the World Wide Web directly using the Hypertext Transfer Protocol, or through a web browser.

看到没有,即便你用浏览器手动拷贝数据下来,也叫做网页抓取(web scraping)。是不是立刻觉得自己强大了很多?

但是,这定义还没完:

While web scraping can be done manually by a software user, the term typically refers to automate processes implemented using a bot or web crawler.

也就是说,用爬虫(或者机器人)自动替你完成网页抓取工作,才是你真正想要的。

数据抓下来干什么呢?

一般是先存储起来,放到数据库或者电子表格中,以备检索或者进一步分析使用。

所以,你真正想要的功能是这样的:

找到链接,获得Web页面,抓取指定信息,存储。

这个过程有可能会往复循环,甚至是滚雪球。

你希望用自动化的方式来完成它。

了解了这一点,你就不要老盯着爬虫不放了。爬虫研制出来,其实是为了给搜索引擎编制索引数据库使用的。你为了抓取点儿数据拿来使用,已经是大炮轰蚊子了。

要真正掌握爬虫,你需要具备不少基础知识。例如HTML, CSS, Javascript, 数据结构……

这也是为什么我一直犹豫着没有写爬虫教程的原因。

不过这两天,看到王烁主编的一段话,很有启发:

我喜欢讲一个另类二八定律,就是付出两成努力,了解一件事的八成。

既然我们的目标很明确,就是要从网页抓取数据。那么你需要掌握的最重要能力,是拿到一个网页链接后,如何从中快捷有效地抓取自己想要的信息。...
立即注册
分享的网址网站均收集自搜索引擎以及互联网,非查问网运营,查问网并没有提供其服务,请勿利用其做侵权以及违规行为。

更新于:2022-05-27 12:48:14
    您需要登录后才可以评论。 立即注册
    相关内容

    python 和 conda

    启动powershell,conda 自动激活base

    python and shell

    为什么使用副 shell 脚本生成 Python 文件

    python 报错整理2

    给出一份「Python 中常见 import 名称 与 pip install 名称不一致」的速查表

    Windows用Conda创建环境报错 CondaToSNonInteractiveError: Terms of Se...

    快速验证顺序是否被改

    Python 学习整理2

    fastapi-speaker-extractor whisperx 项目报错 ValueError: The chosen ...

    python报错 UnicodeEncodeError: 'gbk' codec can't encode character '\u...

    python whisperx 报错 in load_align_model raise ValueError(f'The ch...

    pyannote/embedding 模型是真难引入模型

    Trae 或者是我自己 莫名奇妙创建了个文件,影响了项目代码的运行。

    WhisperX 无法加载模型

    HUGGINGFACE_HUB_CACHE 设置错误导致的问题

    Trae的bug太多了,怪不得免费

    通义之旅

    通义之旅2

    目标说话人声音提取模型训练的思路

    python报错 can't convert cuda:0 device type tensor to numpy. Use Tenso...

    Expected all tensors to be on the same device, but found at least two ...

    腾讯元宝推荐的项目结构(音频处理项目)

    音频处理项目fse

    各种python 相关命令

    python 报错 SyntaxError: 'return' outside function

    python常用命令

    腾讯编程助手

    python一些扩展兼容安装的处理方案

    AI和Python 学习整理

    AudioSeparationGUI 对输入的音频,自动根据说话人进行分类 20250817

    SoloSpeech 项目安装和运行测试 20250817

    python 多项目部署 优先考虑用Anaconda

    espnet 声音分离

    ClearerVoice-Studio 安装测试遇到的问题,安装pysptk一直失败

    uvr5 bs roformer 爆显存以及关于huggingface的国内镜像hf-mirror.com

    用Kimi编程

    Studio One 调试插件Techivation AI-Rack 一键智能混音

    在hf-mirror.com模型镜像站用代码下载模型遇到报错 speaker-diarization模型不...

    用腾讯元宝编程

    Conda国内镜像源

    数字对象标识符 (DOI)

    在创建conda环境时,如果不指定Python版本,conda将不会默认安装Python。

    whisperx 的使用 音频处理

    Win10系统 Trae的使用 关于powershell报错: 因为在此系统上禁止运行脚本

    warp的使用

    AI编程工具比较

    FastApi

    推荐内容

    真枪实弹,假戏真做,12部具有“实干精神”的电影!

    怎样使用V2Ray代理和SSTap玩如魔兽世界/绝地求生/LOL台服/战地3/黑色沙漠/彩...

    sstap游戏代理教程 从此玩如魔兽世界/绝地求生/LOL台服/战地3/黑色沙漠/彩虹六...

    BT磁力搜索网站汇总和找不到的资源

    什么是磁力链接,您如何使用?

    Z-Library:全球最大的数字图书馆/含打不开的解决方案/镜像

    使用V2Ray的mKCP协议加速游戏

    v2rayN已停止工作